LongCat-2.5 发布:从看懂截图到完成工程任务
美团发布面向长程智能体任务的 LongCat-2.5。本文从截图编程场景切入,解释多层级视觉 token、可验证训练任务和 W4A4 推理分别解决什么问题,并结合官方实验图说明证据的适用范围。
把一张网页截图交给 AI,要求它做出相似页面,至少包含两类问题:先识别布局、文字和控件,再把这些信息变成能运行的代码。任务继续延伸到已有项目时,还要找到相关文件、处理依赖、验证修改,并在失败后继续调整。
美团于 2026 年 11 月 2 日发布的 LongCat-2.5,面向的正是包含视觉输入和多步执行的智能体任务。官方公布其总参数规模为 1.6 万亿,并提供在线体验及 API 入口。发布消息
理解这次更新,可以从一个具体问题入手:图片进入模型后,怎样参与后面的任务执行?
图片不必先被翻译成一段文字
一种常见误解是,多模态模型先给图片写说明,再让语言模型阅读说明。这样虽然容易理解,却不能准确描述所有模型的内部处理方式。
LongCat-2.5 的官方技术说明采用了另一种表述:视觉信息被编码成多层级离散 token,再交给主干处理。这里的 token 是可供模型计算的表示单位,并非人类可读的图片说明。技术说明
这条路线沿用了此前 LongCat-Next 的研究。其论文描述,视觉编码器先提取特征,再用残差向量量化(RVQ)把连续特征映射成多层离散编号:前一层近似之后,后一层继续表示尚未覆盖的残差。LongCat-Next 论文
可以把它理解为一种逐层补充的编码方法。先表达主要信息,再补充剩余细节,比用一个粗略编号概括全部内容更有表达空间。这个比喻仅解释量化思路,不代表每一层分别对应“物体、颜色、文字”等固定语义。
论文中的关键目标,是让离散表示保留足够信息,支持视觉理解,并与语言序列的建模方式衔接。它并不意味着图片变成了自然语言,也不意味着视觉处理模块被取消。
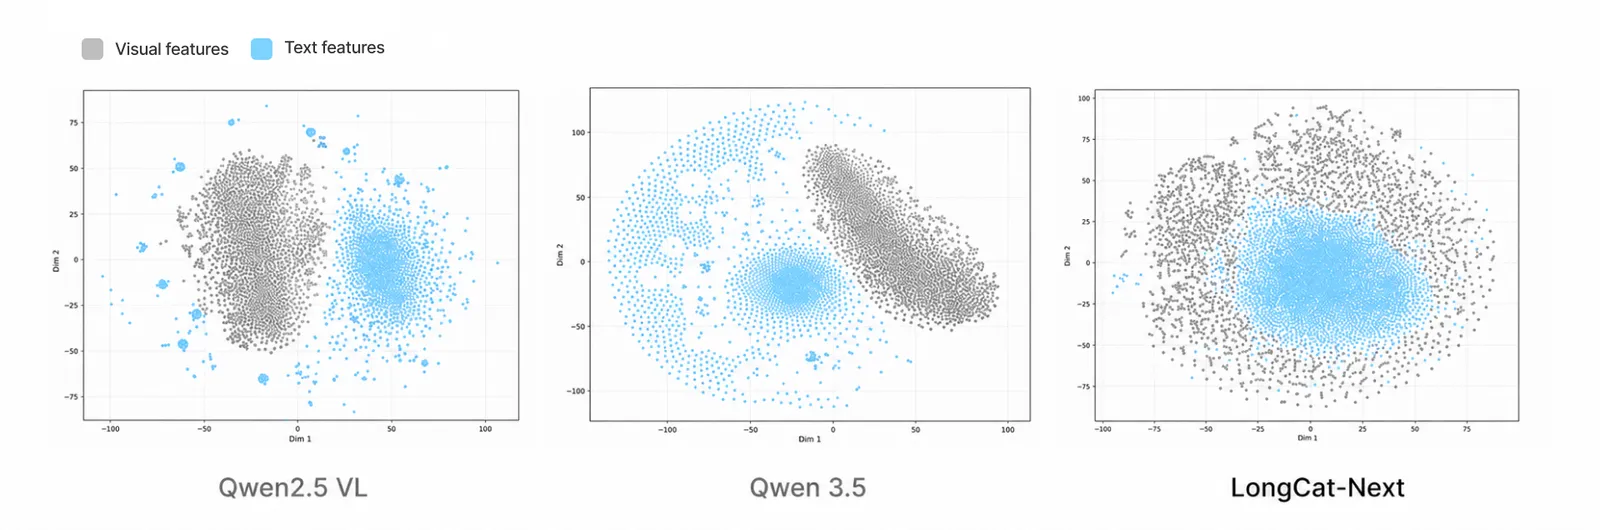
图源:美团技术团队。右图标注为 LongCat-Next,官方说明它来自平均激活参数约 3B 的 MoE 验证模型,并非 LongCat-2.5 正式版的直接测试结果。
图中展示的是高维特征降到二维后的分布。它帮助观察表示之间的关系,不能直接读成“网页还原准确率”或“编程成功率”;点的分布更交织,也不足以单独证明任务执行更可靠。
以网页截图为例,表示层需要留下的不只是“这是一张后台页面”,还包括侧栏位置、表单关系、按钮文字等具体线索。若输入阶段已经丢掉了关键细节,后续再长的推理也可能只是在错误前提上继续生成。因此,视觉表示是任务链条的起点,不能用最终代码的篇幅替代其质量。
完成任务,需要验证中间步骤
多步任务的难点是错误会累积。一个错误的文件判断,可能引出错误的组件修改;一个没检查的依赖问题,可能让最终页面根本无法启动。
美团披露的训练方法包括:把真实 Agent 的失败轨迹转成可复现任务,并利用修改前失败、修改后通过的测试,以及修改前后都应通过的回归测试,校验训练环境。训练方法来源
两类测试检查的是不同问题。前者关注目标缺陷是否修好,后者关注原有功能是否被破坏。只满足其中一种,仍可能得到不合格的修改。
例如,假设任务是修复移动端菜单打不开的问题:
- 目标测试应检查窄屏下点击菜单后,导航项能否出现。
- 回归测试应检查桌面导航、关闭操作和路由跳转是否仍然正常。
这是一组解释测试思路的假设案例,不是 LongCat-2.5 的实测结果。它说明“做完了”需要可观察的判据:生成了代码、发出了工具调用、通过了目标验收,分别代表不同阶段。
同样,失败轨迹的价值不在于数量本身。若任务描述模糊、环境无法复现,或者测试检查了错误的条件,训练就可能奖励表面上通过检查、实际上没有解决问题的行为。可验证环境决定了反馈是否可信。
W4A4 降低的是数值位宽,不是任务步骤
支撑长任务还需要推理效率。官方披露的 W4A4 方案,将专家权重与激活同时量化至 4 bit,并使用原生 INT4 矩阵乘法单元计算。量化方案来源
W 指权重,即训练后保留的参数;A 指激活,即输入经过网络时产生的中间数值。“4”表示相应数值采用的位宽。降低位宽可以减少相关数据的存储和传输量,但需要处理数值近似带来的误差。
这里有两个不同的“离散化”:前面的视觉 token 化解决图片如何表示,W4A4 解决部分计算数值怎样以较低精度保存与运算。它们作用的层面不同,不能把二者理解成同一个压缩步骤。
同样,4 bit 也不意味着整台服务器的内存、总计算时间和最终费用都会按同一比例下降。工具执行、缓存、通信及其他计算仍有各自的开销。对于需要反复读取文件、运行测试的工程任务,模型推理只是整体耗时的一部分。
因此,LongCat-2.5 的技术变化涉及三件相互关联、又各有分工的事:保留视觉输入中的信息,以可验证任务训练执行能力,再降低部署时部分计算的成本。最终表现仍取决于这些环节在真实任务中的配合。本文未实际调用该模型,不提供独立成功率或模型排名。
资料核查日期:2026 年 11 月 3 日。封面与正文实验图均来自美团技术团队发布资料。
参考资料:
评论
0友善交流,理性表达