Genie 4:AI 开始生成可以走进去的世界,但还不是可靠的模拟器
Google DeepMind 的 Genie 4 把实时交互、场景生成与原生音频放到了一起。它可能改变创意原型的制作方式,但持续一致性、可重复性与模拟精度仍需要检验。本文结合官方资料,拆解能力、开放状态与实际使用时值得关注的问题。
看到 AI 生成的一段山谷视频,我们通常只能等它播完。但如果能在途中转身、改变天气,再看环境怎样回应,体验就从“看一段片子”变成了“进入一个场景”。
这正是 Google DeepMind 最近公布的 Genie 4 值得关注的方向:让人能够持续干预正在生成的世界。
资料核查日期:2026 年 11 月 2 日。Genie 4 于 10 月 27 日公布,本文是近期热点解读,并非今日新发布消息。本文未进行产品实测。
Genie 4 带来了什么?
根据 DeepMind 官方发布文章,Genie 4 将实时场景生成与原生音频结合:用户可以用文字调整环境,场景中的人物也可以产生随互动变化的对话。Gemini 模型参与场景理解和分步规划,再结合持续生成的画面调整后续过程。
这可以用一个想象中的创作任务来理解:先搭出一条雨后的街道,再要求镜头拐入小巷、让路人停下来交谈。传统创作流程往往要分别处理场景、镜头和声音;交互式生成试图把这些修改放到同一段持续进行的体验里。
这个例子只是对用途的说明,不是本文实测,也不意味着任意复杂指令都能稳定实现。
从“生成结果”到“接受反馈”
我更关注的变化,是创作过程里反馈出现的位置。
生成一段视频时,使用者常常要等结果出来,再决定是否重做。一个能持续接受操作的环境,则有机会让人边走边改:先尝试一个方向,看到结果,再提出下一步要求。
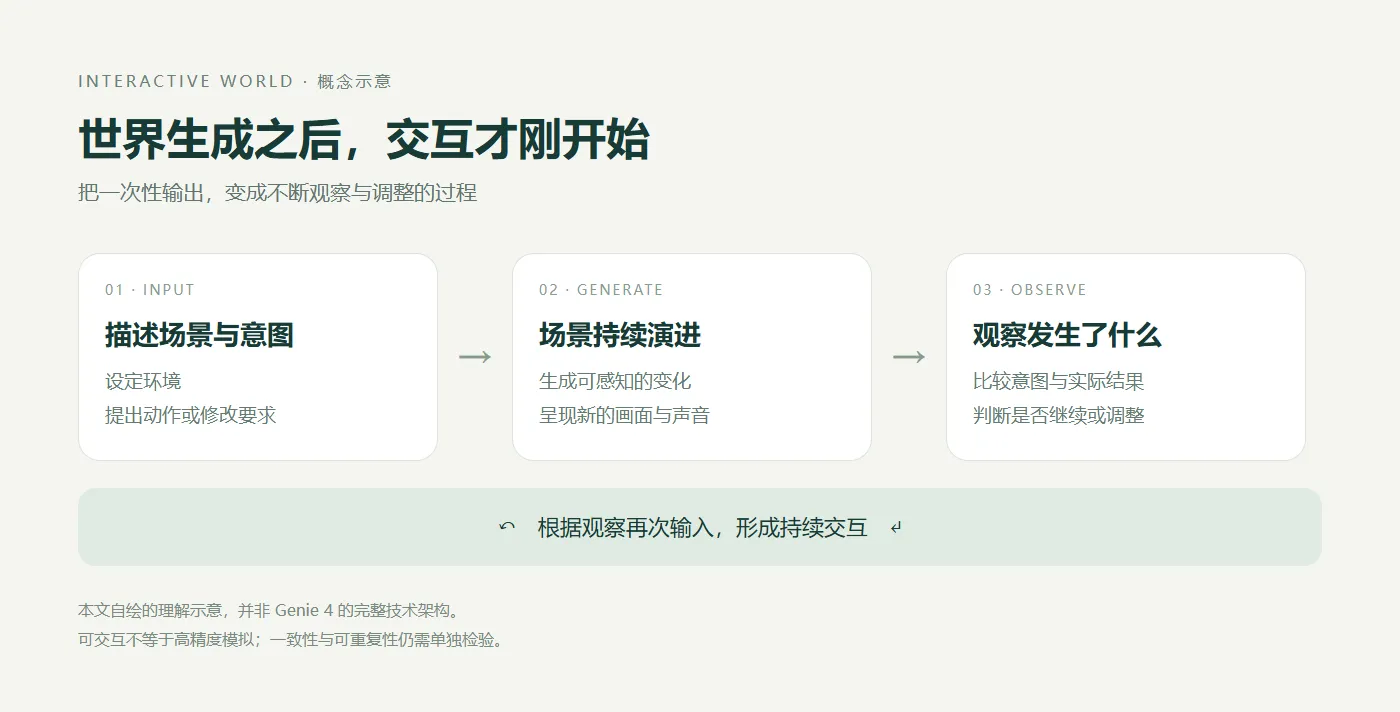
上图为本文自绘的理解示意,不代表 Genie 4 的完整技术架构。
这种方式如果足够稳定,可能改变早期方案讨论的效率。
比如,一位导演和美术讨论空间布局,双方对“更压抑的走廊”可能有完全不同的想象。与其继续堆叠形容词,不如先进入一个粗略场景,再一起调整灯光、视角和尺度。此时,生成环境的价值在于帮助人暴露分歧、比较方案。
对游戏原型也一样。一个想法是否值得继续投入,往往先取决于体验能不能成立。可以快速探索的场景,可能帮助团队更早排除不合适的方向。不过,原型好看与玩法完整、程序可维护,仍然是几件不同的事。
这些是我对潜在工作流的判断,实际收益仍需要具体项目验证。
最需要盯住的,是“过一会儿还对不对”
官方的 模型页面与限制说明 提醒:目前连续互动仍是几分钟量级;物体与视觉细节可能随时间漂移,复杂交互、真实地点还原和音频准确性也有待改进。开放状态仍是面向受邀测试者的研究预览,后续计划覆盖 Project Genie 的 Google AI Ultra 用户及部分开发者早期访问渠道。
因此,评估这类系统时,我会先设计几个很朴素的检查,而不是只挑最好看的十秒钟:
| 检查问题 | 为什么值得测 |
|---|---|
| 转身再回来,刚才的物体还在吗? | 看空间与物体状态能否保留 |
| 连续修改几次,场景是否仍遵守最初要求? | 看多轮干预会不会逐渐失控 |
| 同样的操作反复执行,结果是否合理? | 看交互规则是否足够稳定 |
| 失败发生时,能否回到某个可比较的状态? | 看问题是否便于复现与排查 |
这是一份我建议采用的观察清单,不是官方公布的测试结果。
以“放下一只杯子”为例:杯子落到桌上,看起来很自然,只能说明这一次画面具有说服力。如果转身回来杯子消失,或者轻推桌子后杯子反而穿了过去,这个环境在需要持续状态的任务中就会遇到麻烦。
一个用于灵感探索的场景,可以容忍偶尔偏离;一个用于训练或验证操作策略的环境,则必须更认真地回答:它的错误会不会教给使用者一套错误的规律?
两类用途的验收标准应当分别制定。不能因为演示吸引人,就直接推导出它适合承担高精度模拟。
对普通创作者,先找一个小任务
如果未来获得访问资格,我会建议从范围清楚、容易判断成败的任务开始:
- 为一个短场景比较两种镜头路线。
- 为游戏概念探索几种空间氛围。
- 把一个抽象创意变成能讨论的视觉草案。
先记录它节省了哪一步、增加了哪些返工,再决定是否放进日常流程。不要一开始就让它承担完整游戏、精确工程仿真或长时间连续叙事。
同样重要的是内容标识。想象出来的历史街景,即便十分逼真,也不能当作真实影像证据使用。发布时应说明哪些部分来自生成、哪些判断有现实资料支撑。
Genie 4 让我感兴趣的地方,是它把“下一步会发生什么”变成了可以尝试、可以干预的创作界面。接下来真正值得追踪的,是这种自由能在多长时间、多复杂的操作下保持可信,以及创作者能否把偶尔惊艳的结果变成可重复的工作方法。
参考资料
封面由 AI 辅助生成,为原创概念插画,不是 Genie 4 的输出截图;正文流程图由本文自绘。
评论
0友善交流,理性表达